GPU 共享怎么选:KAI vs HAMi vs MIG
Kubernetes 上的 GPU 共享:KAI、HAMi 与 MIG 对比。
📝 摘要
本文系统对比了 Kubernetes 环境下三种 GPU 共享方案:NVIDIA KAI Scheduler(调度层软隔离)、HAMi(软件层 CUDA 拦截强制隔离)和 NVIDIA MIG(硬件层物理分区),剖析了各自的技术原理、优缺点和适用场景。文章指出全球 23000+ K8s 集群平均 GPU 利用率仅约 5%,而 Kubernetes 原生只支持整卡分配,这是 GPU 共享需求的核心驱动力。
核心概念: GPU 共享的本质问题是"你有多信任共享这张卡的工作负载"——完全信任选 KAI(零成本利用率),信一半选 HAMi(软件围栏),完全不信选 MIG(硅片之墙)。
关键技术栈 / 关键要点:
- KAI Scheduler — NVIDIA 开源的 AI 工作负载调度器,通过 gpu-memory/gpu-fraction 注解实现分数调度,但运行时零强制执行,Pod 可轻松冲破份额,适合可信内部工作负载
- HAMi — CNCF 孵化项目,通过 libvgpu.so(LD_PRELOAD)拦截 CUDA 调用路径,在 cudaMalloc 时检查显存/SM 限额,超限返回 CUDA OOM,支持 NVIDIA/AMD/昇腾/寒武纪等异构加速器
- NVIDIA MIG — 硬件级分区(Ampere+ 数据中心 GPU),将 GPU 切成最多 7 个物理隔离实例,每个实例拥有独立算力/显存/带宽/故障域,最强隔离但固定 profile 且需腾空节点变更
- HAMi × MIG 组合 — 两者可兼得:MIG 提供硬件分区,HAMi device plugin 通过 NVML 自动创建 MIG 切片,Pod spec 中无需出现 MIG profile 名
- DRA 动态资源分配 — K8s 1.34 迎来 GA,用类型化 ResourceClaims 取代不透明扩展资源字符串,三种方案将迁移到 DRA 上
- GPU 隔离三层机制 — nvidia.com/gpu(K8s 调度预留)、NVIDIA_VISIBLE_DEVICES(容器级设备屏蔽)、CUDA_VISIBLE_DEVICES(Pod 内子选择),真正隔离依赖 NVIDIA_VISIBLE_DEVICES
关键结论 / 实践建议: 大多数共享推理集群适合 HAMi(在不支持 MIG 的卡上获得真实显存上限);不受信任/受监管租户选 MIG;可信团队只求利用率选 KAI。三者可同时运行在各自层上(调度/软件/硅片),且 HAMi-core 已被 KAI Scheduler 用于显存强制执行。
Kubernetes 上的 GPU 共享:KAI、HAMi 与 MIG 对比。一张 GPU 卡上运行 Gemma 4、gpt-oss-20b、DeepSeek-OCR-2 和 Qwen3.5-9B;下方三张卡分别示意:KAI Scheduler 是没有栅栏的调度,HAMi 是软件栅栏,NVIDIA MIG 是硬件里的墙。
本文译自 GPU Sharing? KAI vs HAMi vs MIG(CloudDude,cloudthrill.ca)
引言
2026 年,AI 资本开支高达 4010 亿美元,而 23000 多个 Kubernetes 集群的平均 GPU 利用率却只有 5% 左右。这个落差,是没人愿意谈的丑陋真相。
在我最近的博客《vLLM 部署 DeepSeek》里,我们把一个 643GB 的“巨无霸”切分到 16 张 H100 上,因为它大到装不进单个节点。今天我们面对的是相反的问题: 一张 GPU,多个模型 ,而 Kubernetes 没有任何办法把这张卡切开。拿两个跑小模型的 vLLM Pod 来说,它们本可以同时装进一张 H100,Kubernetes 却不允许共享: nvidia.com/gpu: 1 已经是它认识的最小单位,于是每个 Pod 各抓一整张卡,又几乎不去用它。在一个 8 卡节点上,第 9 个模型只能 Pending,而 8 张卡都半空着。
那么,如何在不互相干扰的前提下,让一张卡装下更多模型?这正是本文要展示的内容。
关于 GPU 共享,你一直被忽悠了
CPU 每秒换出换入线程数千次,人人都能分到公平的一段时间片。GPU 消受不了这种做法:一个运行中的 kernel,其状态遍布每一个 SM(寄存器、共享内存、缓存),规模可达数十 MB,想在运行途中暂停它几乎不可能。这就是为什么 GPU 的工作单元会占住整卡直到跑完,其他一切只能等待。
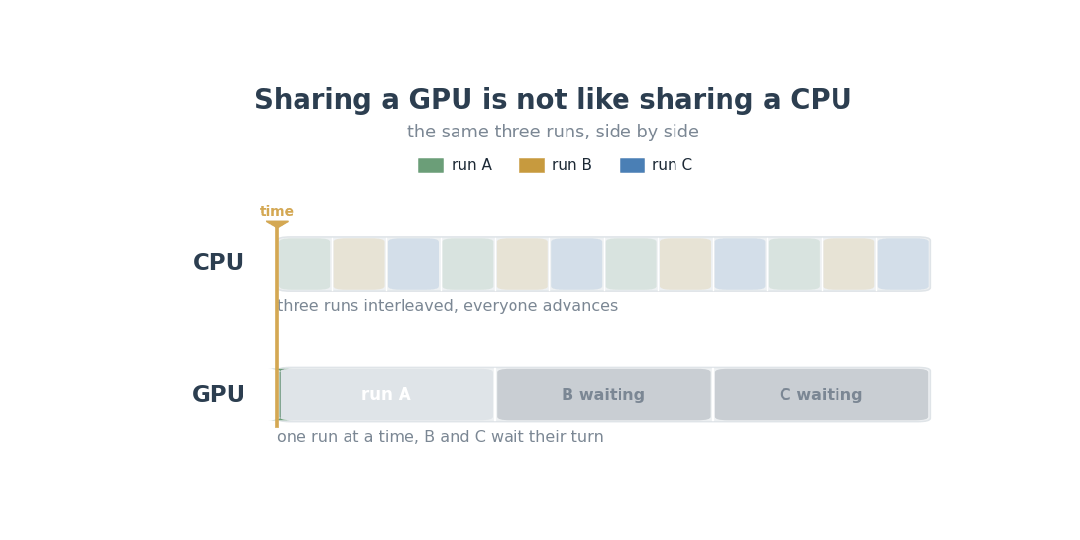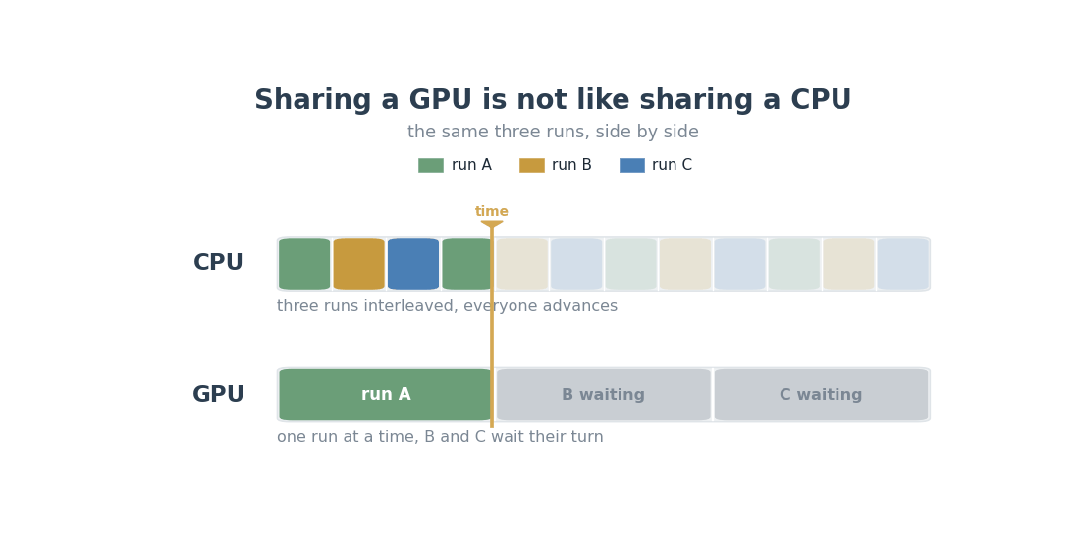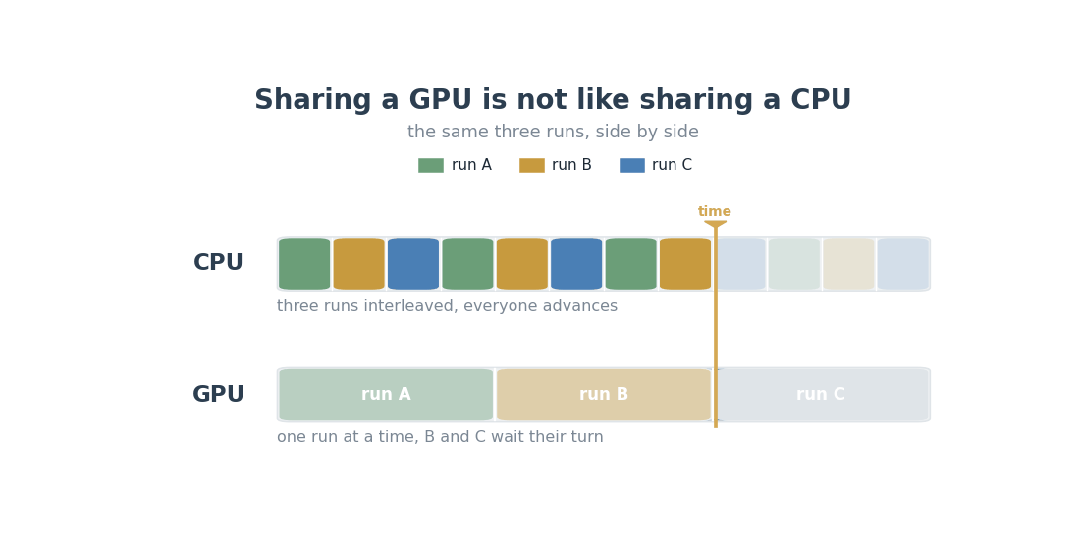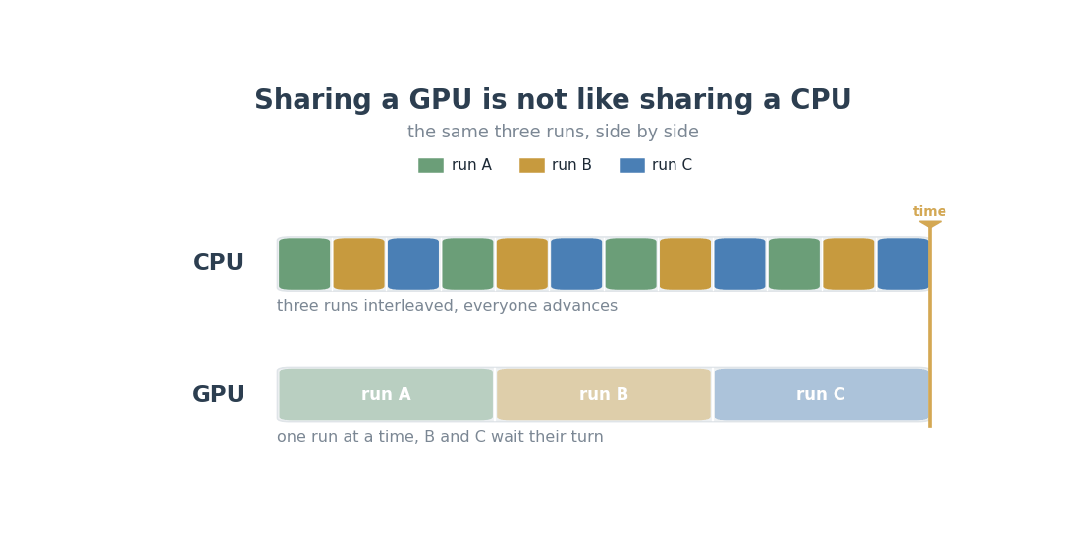
CPU 上三个任务交错运行、都在推进;GPU 上一个推理任务占住整卡,其他任务等待
Kubernetes 让情况更糟。它用 cgroups 限制 CPU 和内存,却没有 GPU cgroup,于是只能整卡发放,否则免谈。vLLM 进程则会把给它的都拿走:装权重和 KV cache 的 HBM、全部算力,直到进程退出。一卡一租户。所有“共享”GPU 的工具都在造假:有的强制执行切分,有的只是指望你自觉。
GPU 共享:人们的尝试与失败
Pod 是如何拿到 GPU 的
在共享 GPU 之前,先看看一个 Pod 是怎么拿到 GPU 的。三层机制决定这件事,而只有最上面一层属于 Kubernetes:
| 层 | 由谁设置 | 作用 |
|---|---|---|
nvidia.com/gpu |
你设置,由 Kubernetes 调度器强制执行 | 在节点上预留一整块 GPU,且不会把同一块卡再分给另一个 Pod |
NVIDIA_VISIBLE_DEVICES |
NVIDIA container toolkit,值为被预留 GPU 的 UUID | 屏蔽其余所有卡,让 Pod 只看到自己的卡,这才是真正的隔离 |
CUDA_VISIBLE_DEVICES |
你,或推理引擎(vLLM、PyTorch) | 在已经可见的卡里再挑选,只在单个 Pod 内部做子选择,从不提供跨 Pod 隔离 |
你真正依赖的隔离是 NVIDIA_VISIBLE_DEVICES :NVIDIA 的工具链会隐藏除分配给你的那张卡之外的所有卡,这就是为什么一个健康的 Pod 里 nvidia-smi 只显示一块 GPU(例如 gpt-oss-20b 在一张 H100 上占掉 81GB 中的 75GB):
root@vllm-gpu-stack-gpt-oss-20b:/vllm-workspace$ nvidia-smi     # 输出有删减
+-----------------------------------------+------------------------+----------------------+
|   0  NVIDIA H100 80GB HBM3          On  |   00000000:5D:00.0 Off |                    0 |
| N/A   29C    P0            114W /  700W |   75079MiB /  81559MiB |      0%      Default |
+-----------------------------------------+------------------------+----------------------+
|    0   N/A  N/A            272      C   VLLM::EngineCore                       75070MiB |
+-----------------------------------------------------------------------------------------+
绕过手段:设置 privileged: true ,Pod 就能看到节点上所有的 /dev/nvidiaX ,无论当初分配给它的是什么。两个模型就这样在没人点头的情况下挤上了同一张 GPU。很多 Helm chart 出于 RDMA 或 InfiniBand 的需要默认打开它,或在副本恰好占满整个节点时打开,但这些场景都非常特定。
时间片并不切分时间
谎言从这里开始。在 CPU 的世界里,时间片意味着内核按固定间隔强行暂停进程,让每个进程都得到公平的一轮。GPU 时间片完全没有这些动作。它只是让 device plugin 把一张卡宣告成 N 个 GPU,好让 Kubernetes 往上面塞 N 个 Pod。一个 Pod 启动了一个跑 5 秒的 kernel,另外三个就干等 5 秒。仅此而已。
做这件事你甚至不需要 device plugin。我在 vLLM Production Stack 上的那次 hack 就是手动玩了同样的把戏:删掉 GPU request,让 K8s 永远不锁卡,显存交给 vLLM 自己管。
modelSpec:
  - name: "tinyllama-gpu"
    replicaCount: 2
    # requestGPU: 1     # 已移除:绕过 K8s 的设备锁
    nodeSelectorTerms:
      - matchExpressions:
          - key: workload-type
            operator: "In"
            values: ["gpu"]
两个副本,一张 GPU,零隔离。它能一直跑下去——直到某个副本的 context 长大、另一个副本死掉。这正是接下来三个工具各自要解决的问题,它们分别工作在技术栈的 不同层(调度、软件、物理) 。
方案一览
| KAI Scheduler | HAMi | MIG | |
|---|---|---|---|
| 所在层 | 调度器 | 运行时(CUDA 拦截) | 硬件(硅片) |
| 是否强制 | 否,只做编排 | 是,显存 + 算力 | 是,物理隔离 |
| 硬件要求 | 任意 NVIDIA GPU | 任意 CUDA GPU(+ NPU/MLU/DCU) | 仅限 NVIDIA 数据中心级 Ampere 及以上 |
| 许可证 | Apache 2.0(NVIDIA) | Apache 2.0(CNCF) | NVIDIA,在支持的硬件上免费 |
一句话总结 :三种不同程度的强制——只编排、用软件强制、用硅片强制。选择权在你。
一、KAI Scheduler:换汤不换药的谎言
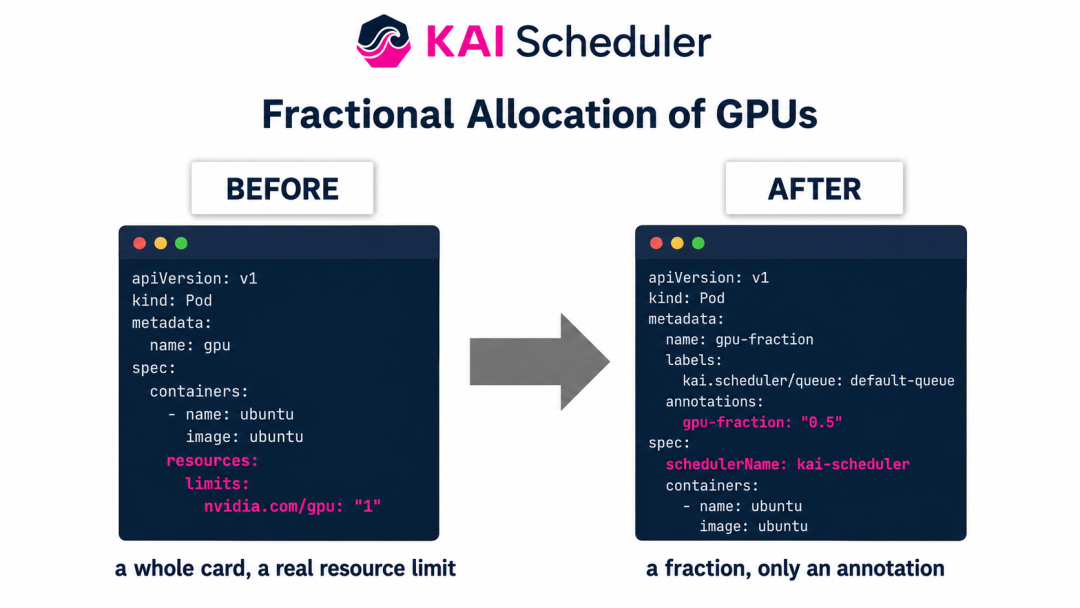
KAI Scheduler 的 GPU 分数分配:之前,Pod 通过 nvidia.com/gpu 资源限额申请整卡;之后,通过 gpu-fraction 注解申请分数,并把 schedulerName 设为 kai-scheduler
KAI 是 NVIDIA 开源的、面向 AI 工作负载的 Kubernetes 调度器,它并不比时间片强多少。它把共享调度得很体面——它是 NVIDIA Run:ai 的核心调度引擎——但运行时没有任何裁判。K8s 只认识整卡,于是 KAI 只能伪造分数:在 kai-resource-reservation 命名空间里放一个预留 Pod,用普通的 nvidia.com/gpu 请求占住卡;kube-scheduler 看到卡已被占用,由 KAI 决定哪些 Pod 来共享它。
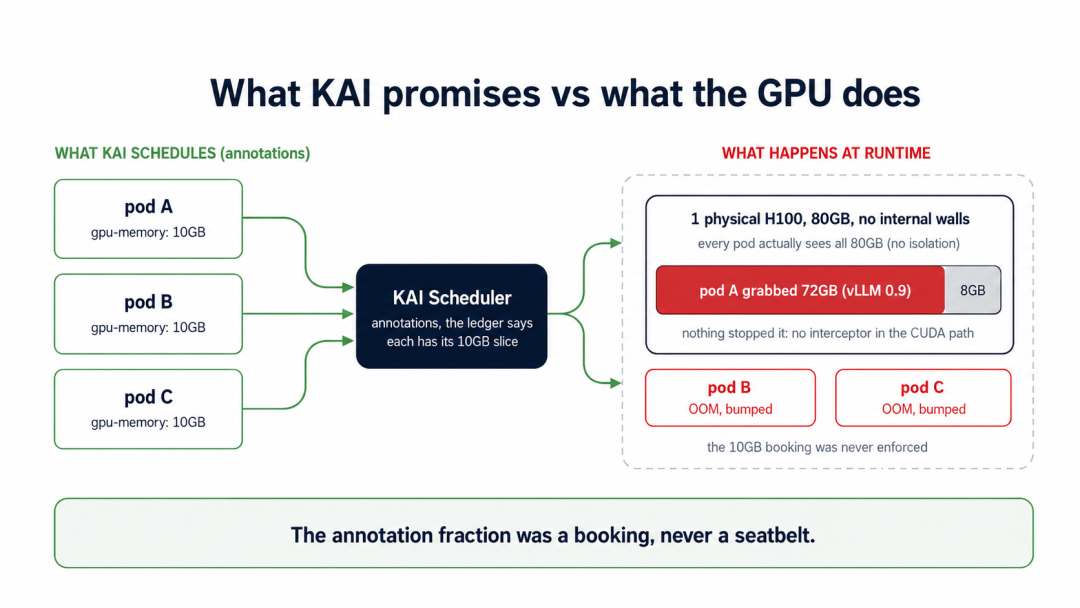
KAI 承诺的与 GPU 实际做的:三个 Pod 各自注明 gpu-memory 10GB,KAI 记了账;但运行时一个 Pod 抓走共享 80GB 卡中的 72GB,另外两个被 OOM 顶掉
看 gpu-memory: 10GB 这个 注解(annotation) ,它只决定 Pod 落在哪里,落下之后没有任何东西强制执行它。Pod 撞上真实驱动,看到的仍是全部 80GB,vLLM 按 0.9 的配比一把抓走 72GB。预订了各 10GB 的两个邻居被 OOM 顶掉。没有驱逐、没有限流,没有任何东西出手干预。
安装 KAI 用的是它自己的 chart,不是 GPU Operator:
helm upgrade -i kai-scheduler oci://ghcr.io/kai-scheduler/kai-scheduler/kai-scheduler \
  -n kai-scheduler --create-namespace \
  --set "global.gpuSharing=true"      # 共享默认是关闭的
把一个 Pod 交给 KAI 调度长这样,注意缺了什么:
apiVersion: v1
kind: Pod
metadata:
  name: gemma-4-e4b
  labels:
    kai.scheduler/queue: default-queue   # 计费归属的队列
  annotations:
    gpu-memory: "10000"         # 预订量,单位 MiB
    # gpu-fraction: "0.5"       # 或者改为预订整卡的一个份额
spec:
  schedulerName: kai-scheduler  # 交给 KAI,而不是 kube-scheduler
  containers:
    - name: vllm
      image: vllm/vllm-openai:latest
      args: ["--model", "google/gemma-4-E4B-it"]
resources.limits: nvidia.com/gpu 只有一种用法:申请整卡。要申请一部分,必须写 metadata.annotations ,因为 Kubernetes 表达不了分数。而且没有 queue 标签,Pod 根本不会被调度。
**没有强制执行:**与 HAMi 和 MIG 强制执行限额边界不同,注解只是一张便条。没有别的可配置项,因为根本没有东西在被强制执行。
**强制执行是可选且非原生的:**可以通过 HAMi-core 补上一道围栏,这正是下一节的主角。
仓库: github.com/kai-scheduler/KAI-Scheduler
优点
- • Kubernetes 原生,可与默认调度器并行运行
- • 任意分数或精确到 MiB,没有固定档位
- • 面向多团队治理的队列与配额
- • 自动识别 Kubeflow、Ray 和 Argo 工作负载
- • PodGroup 与拓扑感知放置,服务多 GPU 作业
缺点
- • 运行时零强制,Pod 可以轻松冲破自己的“份额”
- • 没有算力隔离,一个长 kernel 拖住其他所有任务
- • 没有公平性,先启动者称王
- • 只有软隔离,对不受信任的租户不安全
- • 实际只支持 NVIDIA,分数化建立在 NVIDIA 的 device plugin 之上
最适合会自我约束的可信内部工作负载:在普通 GPU 上想要高密度装箱和队列治理、不需要租户间硬隔离的场景。
二、HAMi:软件围栏
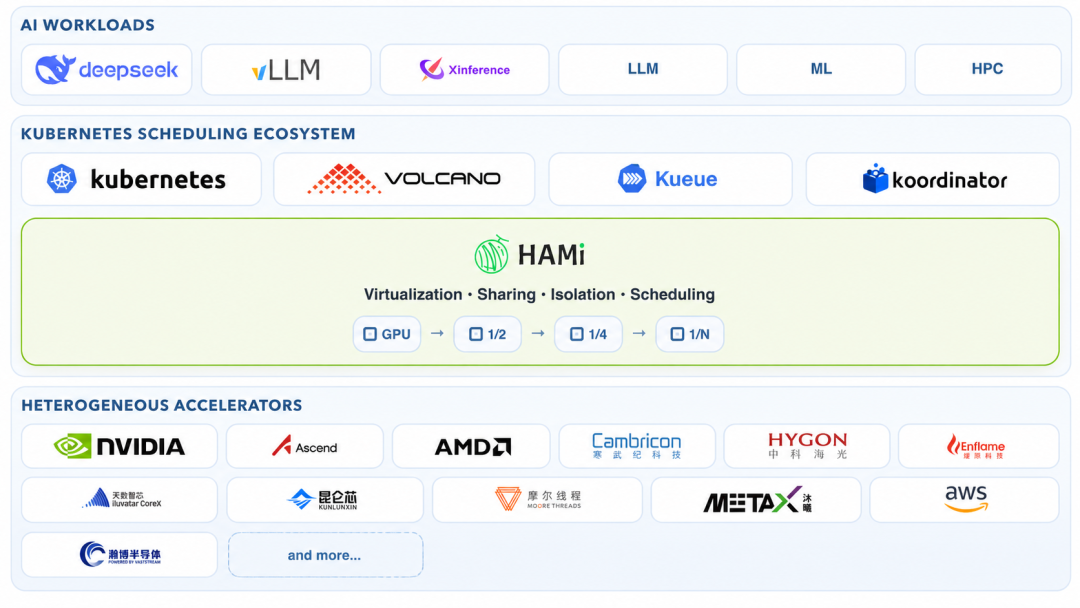
HAMi 架构:上层是 AI 工作负载,中间是 Kubernetes 调度生态,HAMi 提供虚拟化、共享、隔离与调度,把一张 GPU 切成二分之一、四分之一和 1/N,覆盖 NVIDIA、昇腾、AMD、寒武纪等异构加速器
HAMi 是用软件实现的 GPU 虚拟化:硅片不肯强制执行切分,那就由一个库来。它是 CNCF 孵化项目,也是本文中唯一不限于 NVIDIA 的方案:它的设备矩阵覆盖 AMD、昇腾 NPU、寒武纪 MLU 和另外几家加速器。MIG 要求数据中心级硅片,而 HAMi 在你已经拥有的任何 CUDA GPU 上都能跑。
HAMi 如何捕获每一次 CUDA 调用
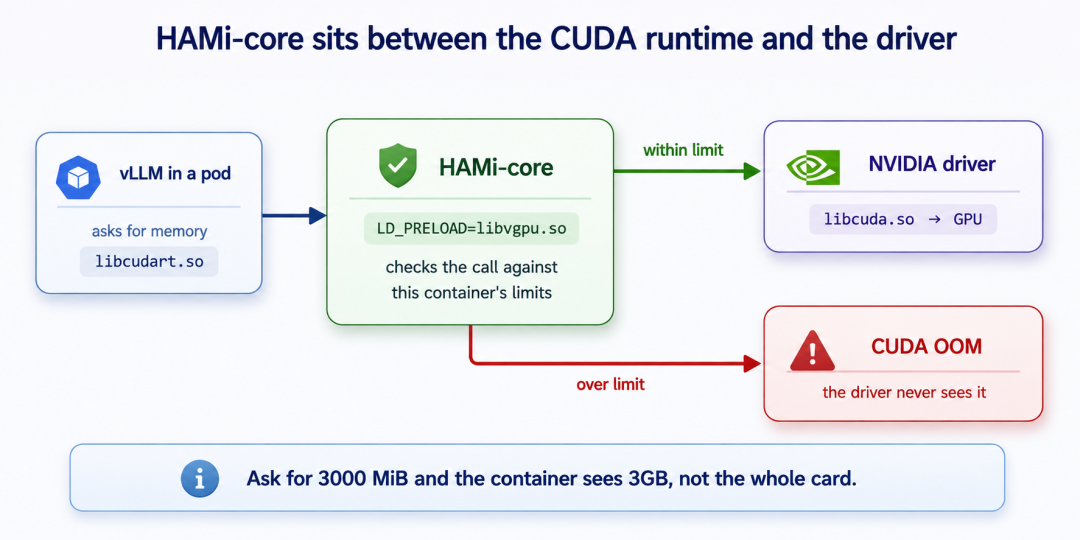
HAMi-core 位于 CUDA 运行时与驱动之间:容器限额内的调用放行至 libcuda.so,超限的调用在驱动看到之前就返回 CUDA OOM
HAMi 提供一个库 libvgpu.so,用 LD_PRELOAD 预加载进你的容器。应用发出的每一次 CUDA 调用,在抵达驱动之前都要先经过它。每一次内存分配都会对照容器的限额检查:限额之内,放行;超出限额,应用收到 CUDA OOM,驱动从头到尾不知情。
限额本身不过是普通的环境变量,整个强制执行层就这两行:
CUDA_DEVICE_MEMORY_LIMIT_0=3000m    # 硬显存上限,每块 GPU 一个变量(_0、_1、……)
CUDA_DEVICE_SM_LIMIT=50             # SM 百分比,对整个容器只设置一次
你在 Pod spec 里写的数字会变成这个环境变量,HAMi-core 在应用每一次 cudaMalloc 时检查它。
设计文档: 了解 HAMi-core 如何钩住 CUDA 调用路径
在 Kubernetes 中用 HAMi 切分 GPU
没有 profile,不用雕琢,不用腾空节点。一个切片就是 Pod 上的资源限额,想要多大就写多大:
apiVersion: v1
kind: Pod
metadata:
  name: qwen3-5-9b
spec:
  containers:
    - name: vllm
      image: vllm/vllm-openai:latest
      args: ["--model", "Qwen/Qwen3.5-9B"]
      resources:
        limits:
          nvidia.com/gpu: 1                  # 这个 Pod 需要的物理 GPU 数
          nvidia.com/gpumem: 12000           # 硬显存上限,单位 MiB(即 12G)
          nvidia.com/gpucores: 30            # 这张卡 30% 的 SM
          # nvidia.com/gpumem-percentage: 50 # 或者按份额申请,而不是按 MiB
这些是调度器会真正记账的 真资源 ,不是 KAI Scheduler 那样的注解。而且 12G 这个尺寸 MIG 切不出来——没有固定形状——于是 gpt-oss-20b 和 Qwen3.5-9B 可以共享一张 H100,各自拿到需要的余量。它们是扩展资源,所以与 CPU 不同, 没有超售 :你没法 request 4GB 而 limit 12GB,request 和 limit 是一回事。
**HAMi 视角:**容器内的 nvidia-smi 报告的是切片,所以 --gpu-memory-utilization 0.9 指的是切片的 90%,而不是整卡的 90%。默认情况下每张物理卡宣告 10 个 vGPU( deviceSplitCount ),一张卡因此显示为 10 个可调度设备。这两面都可以验证:
# 节点侧:一张物理 H100,十个可调度的 vGPU
kubectl get node gpu-node-1 -o jsonpath='{.status.allocatable}' | grep -o 'nvidia.com/gpu":"[0-9]*'
nvidia.com/gpu":"10

# 容器侧:nvidia-smi 报告的是切片而不是整卡(输出有删减)
kubectl exec -it qwen3-5-9b -- nvidia-smi
[HAMi-core Msg]: Initializing ...
|   0  NVIDIA H100 80GB HBM3    |    64MiB / 12000MiB   |
文档: 查看为一个 NVIDIA 切片定尺寸的所有方式
围栏要付出一点延迟代价
HAMi 的隔离过去要付出大约 10% 的延迟。最近它已大幅改善,v2.9 在 A100 上的数据印证了下降的趋势:
| 指标 | 原生(无 HAMi) | 使用 HAMi |
|---|---|---|
| TTFT p50 | 0.0621s | 0.0629s(+1%) |
| TTFT p99 | 0.0652s | 0.0674s(+3%) |
| 每 token 延迟 | 0.0285s | 0.0291s(+2%) |
注意:围栏住在容器里面。当心能控制镜像的租户 unset 掉 LD_PRELOAD 从旁边走过去;CUDA 或驱动一升级,也可能在 HAMi 跟上来之前弄坏拦截。
那 AMD 呢?
HAMi 带着一个 AMD 后端( amd.com/gpu ),目前主要围绕 MI300X 打磨。调度与分配已经可用,用 LD_AUDIT 顶替 LD_PRELOAD :显存和 CU 限额将由 ROCm 运行时与 KFD 驱动强制执行的位掩码来承担。语法如下:
apiVersion: v1
kind: Pod
metadata:
  name: amd-gpu-pod
spec:
  containers:
    - name: rocm
      image: ubuntu:22.04
      command: ["sleep", "infinity"]
      resources:
        limits:
          amd.com/gpu: 1            # 目前支持调度与分配
          amd.com/gpu-memory: 3000  # 单位 MB,注意名字是 gpu-memory 而不是 gpumem
                                    # 尚未强制执行,仅用于调度
优点
- • 真实的显存与算力上限,在 CUDA 调用路径上强制执行
- • 在任何 CUDA GPU 上工作,不需要支持 MIG 的硅片
- • 不限于 NVIDIA:一套工作流覆盖 AMD、昇腾、寒武纪等
- • 任意 MiB 或百分比,没有固定 profile,不用腾空节点
- • 标准资源限额,应用零改动
- • 还能编排 MIG,而且 NVIDIA 的 KAI Scheduler 也用 HAMi-core 做强制执行
缺点
- • 不是安全边界,围栏在容器内部
- • AMD 目前只有调度,ROCm 隔离仍是原型(尚未上游化)
- • 拦截开销,如今很小但不是零,且与负载相关
- • 与 CUDA 和驱动版本耦合,升级可能弄坏钩子
- • 活动部件更多:webhook、scheduler extender、device plugin、容器内的库
- • 物理使用量与强制限额是两个不同的视图,需要分别监控
最适合大多数共享推理集群:需要在 MIG 摸不着的硬件上获得真实显存上限的内部租户,既不用买新硅片,也不用为了改一个切片腾空节点。
HAMi-core 现已被 NVIDIA 的 KAI Scheduler 用于显存强制执行:阅读公告。
三、NVIDIA MIG:硅片之墙
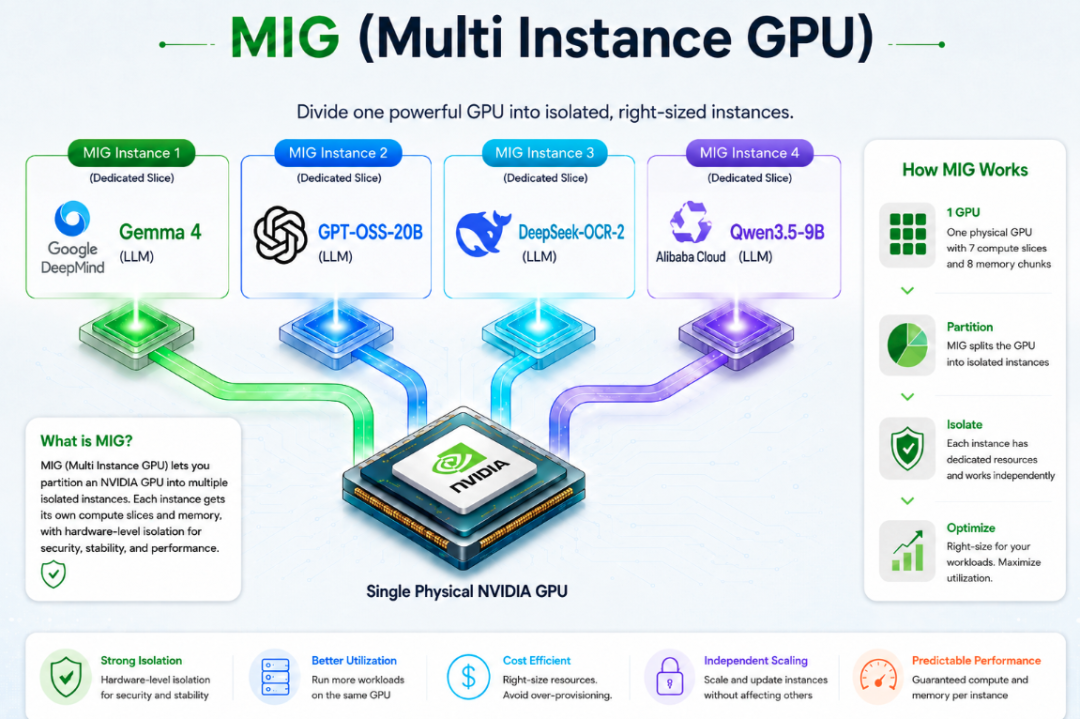
NVIDIA MIG:把一张 GPU 划分为多个隔离的、尺寸合适的实例,四个模型各自占用一张物理卡上的专属切片
Multi-Instance GPU(MIG)是 NVIDIA 在硬件层面的回答。它把 GPU 切成最多 7 个硬件分区 (取自 7 个算力切片和 8 个显存块),每个分区拥有自己的算力、显存、带宽和故障域。分区发生在硅片里,所以一个切片里的崩溃够不到另一个切片,每个切片都以一块独立 CUDA 设备的身份亮相。它是这份名单上最强的隔离,唯一能扛住恶意租户的方案,也是唯一会把你已付费的硅片白白搁置的方案。
MIG 只跑在 NVIDIA 数据中心芯片上(A/H100、……、B200、GB200 等),4090/5090 和 L40S/L4 都不行(AMD 的对应物是 MxGPU)。注意,开启 MIG 要求一张空闲的卡,所以变更拓扑意味着腾空整个节点。
写给小白的 MIG Profile 指南
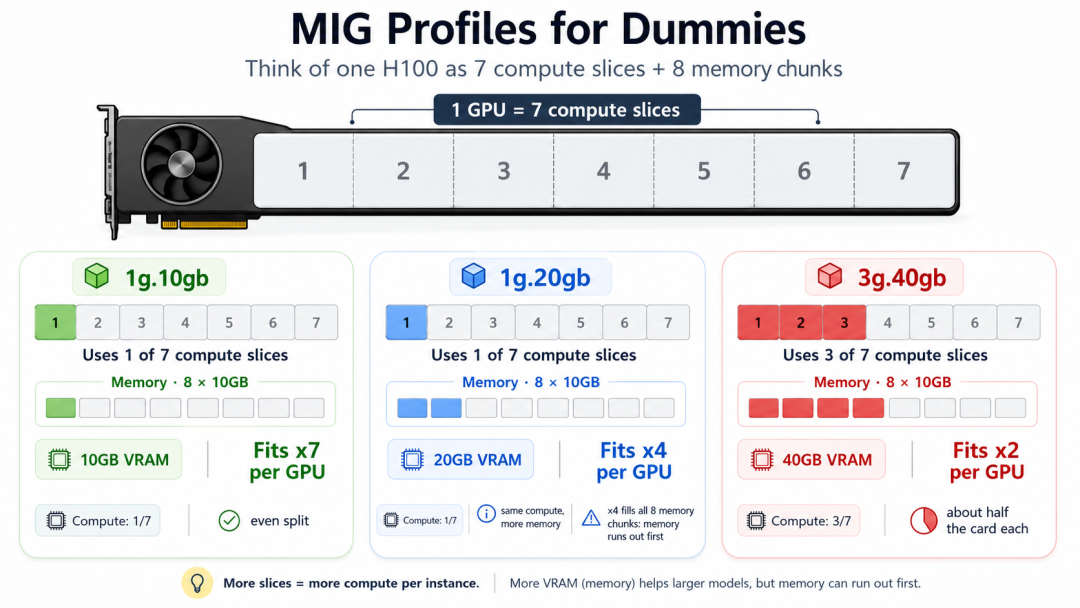
MIG Profile 图解:一张 H100 有 7 个算力切片加 8 个显存块;1g.10gb 一张卡能装 7 个,1g.20gb 因为显存先用完只能装 4 个,3g.40gb 能装 2 个
MIG profile 的名字看起来像序列号,我们把它简化一下。一张 H100 记着 两本独立的账 :算力切成 7 份,显存切成 8 块、每块 10GB。profile 名字只是一张收据:3g.40gb 意思是 7 个算力切片里的 3 个,外加 80GB 里的 40GB。从两本账各取一笔, 哪本账先花光,就由它决定这张卡装得下几个实例 。
Profile 清单: 查看每款 GPU 支持的完整 NVIDIA MIG profile 列表
同样的规则,配上真实模型。B200 用更大的显存单元讲同一个故事,这就是它的切片读作 23、45、90 的原因:
| 切片档位 | H100 80GB 示例 | 切片大小 | B200 180GB 示例 | 切片大小 |
|---|---|---|---|---|
| 1g(1/7 算力) | Gemma 4 E4B(约 8GB BF16) | 10GB | gpt-oss-20b(约 13GB MXFP4) | 23GB |
| Qwen3.5-9B(约 6GB Q4_K_M) | 10GB | |||
| 2g(2/7 算力) | gpt-oss-20b(约 13GB MXFP4) | 20GB | Qwen3.6-27B(约 27GB FP8) | 45GB |
| 3g(3/7 算力) | — | — | Gemma 4 26B-A4B(约 50GB BF16,激活 4B) | 90GB |
注意表格里的细节:在 H100 上,两个小模型在同一张卡上各占一个 1g 切片;而在 B200 上,Gemma 享用单独一个 3g.90gb MIG——3 个算力切片 + 90GB,把权重和 KV cache 都装下。切分时手下留情:两个 3g.40gb 切片用掉 7 个槽位中的 6 个,一张 H100 约有 14% 的算力被闲置(折合每月约 718 美元的已付费硅片没法调度)。
**尺寸自动校正:**vLLM 默认的 --gpu-memory-utilization 0.9 会抓走它看到的那块卡的 90%。MIG 自动把这个尺寸扶正:是切片的 90%,不是整卡的 90%(例如 gpt-oss-20b 放在 2g 切片上:20GB 的 90%)。
Kubernetes 中的 MIG 切分
在底层,一个切片是两个对象:一个 GPU Instance (显存)和一个 Compute Instance (它的算力槽位)。看看切分在 Kubernetes 里怎么做:
# 开启 MIG(Hopper 及以上:驱动开关,无需重置)
nvidia-smi -i 0 -mig 1              # -i 0:指定 GPU 0 | -mig 1:启用 MIG

# 在 GPU 0 上切出两个半卡实例,含算力(-C)
nvidia-smi mig -i 0 -cgi 3g.40gb,3g.40gb -C

# GPU 序号从 0 开始数:给下一张卡切分它自己的布局
nvidia-smi mig -i 1 -cgi 4g.40gb,2g.20gb,1g.10gb -C
切片随后以自己的资源名露面,Pod 像申请任何资源一样申请一块:
apiVersion: v1
kind: Pod
metadata:
  name: gpt-oss-20b
spec:
  containers:
    - name: vllm
      image: vllm/vllm-openai:latest
      args: ["--model", "openai/gpt-oss-20b"]
      resources:
        limits:
          nvidia.com/mig-2g.20gb: 1   # 一个硬件隔离的切片
注意,Pod 申请的是形状,不是地址:如果节点上有六个 2g.20gb 切片,没有任何资源语法能说“给我 GPU 3 上的那个 2g.20gb”(在 Pod 里,nvidia-smi 会告诉你拿到的是哪一个)。使用 mig.strategy: mixed 时,自定义配置可以让同一节点上不同 GPU 有不同的切法(异构形状),你也依然可以通过 nodeSelector 把 Pod 路由到某个特定节点的 MIG 配置上。
自动化:GPU Operator 的 MIG Manager
你不必对每个节点手敲 nvidia-smi。GPU Operator 自带 MIG Manager,它把每个节点调和(reconcile)到声明的布局上,布局放在一个 ConfigMap 里:节点标签决定应用哪一份,切分的活由 MIG Manager 来干。这一切都装得进 Helm values 和 manifest,整个流程对 GitOps 非常友好:
# 安装 Operator,使用以 profile 命名的资源和你的自定义配置
helm upgrade -i gpu-operator nvidia/gpu-operator -n gpu-operator \
  --set mig.strategy=mixed \
  --set migManager.config.name=custom-mig-config
把我们前面的例子声明式地配置一遍:
apiVersion: v1
kind: ConfigMap
metadata:
  name: custom-mig-config
data:
  config.yaml: |
    version: v1
    mig-configs:
      all-disabled:
        - devices: all          # 作用于节点上的每块 GPU
          mig-enabled: false

      h100-fleet:
        - devices: all          # 也可以用 [0,1] 这样的列表指定特定 GPU
          mig-enabled: true
          mig-devices:
            "1g.10gb": 5     # Gemma 4 E4B + Qwen3.5-9B 占两个,还剩三个
            "2g.20gb": 1     # gpt-oss-20b
# 把节点指向一个布局:MIG Manager 会替你完成切分
kubectl label node gpu-node-1 nvidia.com/mig.config=h100-fleet --overwrite

# Operator 还内置了统一布局,全部以 all- 开头:
# all-3g.40gb = 节点上每块 GPU 都切成相同的 3g.40gb 切片(每张 H100 两个)
kubectl label node gpu-node-2 nvidia.com/mig.config=all-3g.40gb --overwrite
**标签依赖:**MIG Manager 是朝标签调和的。没有标签,或标签过期,你的全部布局就没了。事实来源变成了这个标签,而不是你的 nvidia-smi。
实战: 阅读 Kubesimplify 的 MIG 深度文章:每条命令、两个方向。MIG Manager 的这个坑就来自上文链接中 Saiyam Pathak 的 Kubesimplify 深度文章,值得完整读一遍。
优点
- • 真正的硬件隔离,对不受信任和受监管的租户安全
- • 故障隔离与有保障的 QoS,延迟确定
- • 没有拦截开销,每个切片都是真实的 CUDA 设备
- • NVIDIA 背书,在支持的硬件上免费
缺点
- • 仅限 NVIDIA 数据中心级 Ampere 及以上:AMD、更便宜或更老的卡无缘
- • 固定 profile,无法在线调整大小
- • 变更 profile 需要腾空并重新部署整个节点
- • 槽位网格与放置规则会搁置未用的容量
最适合不受信任或受监管、需要硬件级保障隔离与确定性 QoS 的租户,前提是你已经拥有 A100、H100 或 B200 级别的硬件。
HAMi × MIG:两全其美
是的,两者可以兼得。把节点切到 MIG 模式,HAMi 的 device plugin 会通过 NVML 自己创建 MIG 切片,不需要腾空节点,于是一个资源池可以同时容纳“软件围栏”节点和“硬件分区”节点。Pod spec 几乎不变,也不需要出现任何 MIG profile 名(HAMi 替你挑 profile):
apiVersion: v1
kind: Pod
metadata:
  name: gpt-oss-20b
  annotations:
    nvidia.com/vgpu-mode: "mig"        # 用真实的 MIG 实例来满足这个请求
spec:
  containers:
    - name: vllm
      image: vllm/vllm-openai:latest
      args: ["--model", "openai/gpt-oss-20b"]
      resources:
        limits:
          nvidia.com/gpu: 2            # HAMi 的资源,全程不出现 profile 名
          nvidia.com/gpumem: 8000      # 每个实例至少 8GB
正面对决
| KAI Scheduler | HAMi | MIG | |
|---|---|---|---|
| 粒度 | 任意分数或 MiB | MiB 或 %,外加核心百分比 | 固定 profile,最多 7 个 |
| 运行时开销 | 无(仅调度) | 推理上百分之几 | 无(原生切片) |
| K8s 集成方式 | 预留 Pod、队列、配额 | Webhook + scheduler extender + device plugin | GPU Operator + mig-parted,mig-* 资源 |
| 适用场景 | 可信团队、能自我限流的应用 | 在不支持 MIG 的卡上强制限额 | 不受信任的租户、需要保障的 QoS |
如何选择
调度层——选 KAI:你运行一个可信的多团队集群,想要利用率与队列治理,而且你的应用已经会自己管住显存。你买的是更聪明的放置,不是围栏。
软件层——选 HAMi:你需要强制执行的显存上限,但你的卡不支持 MIG(L40S、消费级卡、更老的前 Hopper 卡)。你想要真实的限额,又不想为此购买切分硅片。
硬件层——选 MIG:你的租户不受信任或受监管,需要硬件保障的隔离与确定性 QoS,而且你手里是 A100、H100 或 B200 级的 GPU。
正在到来:动态资源分配(DRA)
Dynamic Resource Allocation 在 Kubernetes 1.34 迎来 GA,它是这个领域正在收敛到的原生设备 API。KAI、HAMi 和 MIG 不会被它取代,而是搬到它上面:用类型化的 ResourceClaims 取代 nvidia.com/gpumem 这类不透明的字符串。类型化意味着这些申请是调度器和厂商驱动都认识的字段——显存和核心——而不是一串抽象的整数:
# 今天:不透明的扩展资源
resources:
  limits:
    nvidia.com/gpu: 1
    nvidia.com/gpumem: 4000        # 只是一个数字

# DRA:类型化请求,调度器负责记账
kind: ResourceClaim
spec:
  devices:
    requests:
      - name: gpu-0
        exactly:
          capacity:
            requests:
              cores: 30            # SM 的百分比
              memory: "4Gi"
结语
回头看,这其实只是一个问题:你有多信任共享这张卡的那些工作负载?完全信任,KAI 几乎不花成本就买来利用率;信一半,HAMi 在你拥有的任何 GPU 上守住底线;完全不信,只有 MIG 的硅片之墙能行——被搁置的容量也一并收下。
你多半会同时运行不止一个方案,各自守在各自的层上(调度、软件、硅片)。希望这篇文章给了你足够的 GPU 共享视野,去挑出你的工作负载真正需要的那一个。
如需转载,请保留全文;如需改写,请先通过微信 HAMi_community 联系我们。
关于HAMi
HAMi 是由李孟轩与张潇共同发起的异构算力虚拟化与统一调度开源项目,现为 CNCF Incubating 项目,以“让异构算力因开源而好用”为目标,致力于提升异构算力利用率,并为异构 GPU 提供统一的复用接口。目前,HAMi 已支持 NVIDIA、AMD、昇腾、寒武纪、海光、天数智芯、摩尔线程、沐曦、燧原、昆仑芯、壁仞、AWS Neuron、瀚博半导体等多种异构算力,与 Volcano、Kueue、Koordinator、vLLM、KAI Scheduler 等项目广泛集成,吸引了来自全球 20 多个国家和地区的 500 余名贡献者参与,并已在数百家企业实现生产落地。
GitHub:https://github.com/Project-HAMi/HAMi
Read more