GLM-5 系列模型演化历程
GLM-5 系列模型演化历程
智谱AI(Z.ai)的 GLM 系列从 GLM-5 到 GLM-5.2 经历三次重大迭代,每次均有明确的技术突破点:架构基础 → Agent 持久性 → 极致长上下文与编码效率。本文基于多源深度调研(101 个子代理、19 个源、94 条 claim、3-投票对抗验证)梳理完整演化路径。
Open: Pasted image 20260620141932.png
演化总览
timeline
    title GLM-5 系列演化时间线
    section GLM-5 (2026-02-12)
        首次集成 DeepSeek Sparse Attention : MoE 架构从 355B/32B 扩至 744B/40B
        预训练数据从 23T 增至 28.5T tokens : 面向复杂系统工程与长程 Agent
    section GLM-5.1 (2026-04-07)
        定位 agentic engineering 旗舰 : 克服早期策略耗尽问题
        支持最长 8 小时自主工作 : 多轮 SFT+RL+过程质量评估
    section GLM-5.2 (2026-06-16)
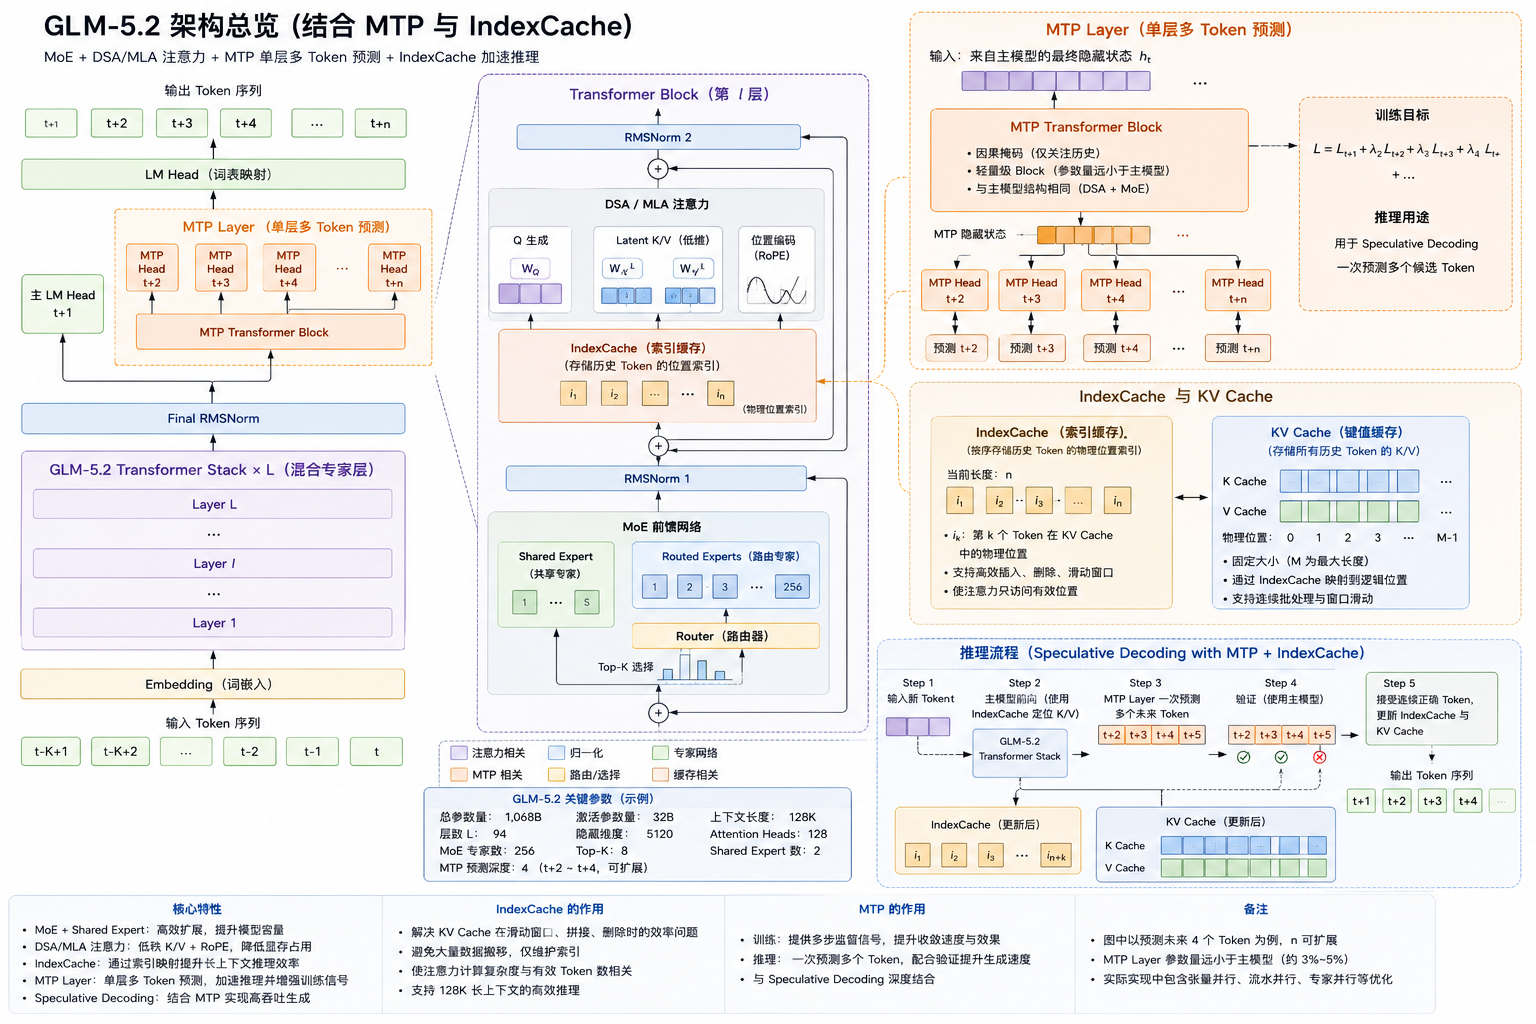
        上下文从 200K 扩至 1M tokens : 引入 IndexShare 架构
        编码评测开源 SOTA : 仅次于闭源 Claude Opus 4.8
架构演化
flowchart TB
    subgraph GLM4["GLM-4.5 基线"]
        A1["355B 总参数<br>32B 活跃参数"]
        A2["23T 预训练 tokens"]
        A3["传统注意力机制"]
    end

    subgraph GLM5["GLM-5 — 架构突破"]
        B1["744B 总参数<br>40B 活跃参数"]
        B2["28.5T 预训练 tokens"]
        B3["DeepSeek Sparse Attention<br>DSA — 稀疏注意力"]
        B4["slime 异步 RL 基础设施<br>开源: THUDM/slime"]
    end

    subgraph GLM51["GLM-5.1 — Agent 持久性"]
        C1["多轮 SFT + RL<br>+ 过程质量评估框架"]
        C2["克服早期策略耗尽<br>600+迭代持续有效"]
        C3["最长 8h 自主工作"]
    end

    subgraph GLM52["GLM-5.2 — 长上下文革命"]
        D1["1M 上下文窗口<br>5x于前代 200K"]
        D2["IndexShare 架构<br>每4层共享轻量索引器"]
        D3["per-token FLOPs 降低 2.9x<br>mid-training 128K 序列训练"]
        D4["编码开源 SOTA"]
    end

    GLM4 --> GLM5
    GLM5 --> GLM51
    GLM51 --> GLM52

    style GLM5 fill:#1a1a2e,stroke:#e94560,color:#fff
    style GLM51 fill:#16213e,stroke:#0f3460,color:#fff
    style GLM52 fill:#0f3460,stroke:#533483,color:#fff
关键架构对比
| 特性 | GLM-4.5 | GLM-5 | GLM-5.1 | GLM-5.2 |
|---|---|---|---|---|
| 总参数 | 355B | 744B | 744B* | 744B* |
| 活跃参数 | 32B | 40B | 40B* | 40B* |
| 预训练数据 | 23T | 28.5T | — | — |
| 注意力机制 | 传统 | DSA(稀疏) | DSA | DSA + IndexShare |
| 上下文窗口 | — | 200K | 200K | 1M |
| 核心定位 | 通用 | 系统工程+Agent | Agentic Engineering | 长上下文+编码 |
| 开源许可 | — | MIT | MIT | MIT |
⚠️ *GLM-5.1 和 GLM-5.2 的参数规模未获独立确认(对抗验证中 1-2 vote 被否决),但官方博客声明与 GLM-5 相同规格。Design Arena 独立分析也确认 GLM-5.2 与 GLM-5.1 "same size at 744 billion parameters"。
IndexShare 架构详解
flowchart LR
    subgraph 传统DSA["传统 DSA(每层独立索引器)"]
        L1["层1: 独立索引器<br>点积 + topk"]
        L2["层2: 独立索引器<br>点积 + topk"]
        L3["层3: 独立索引器<br>点积 + topk"]
        L4["层4: 独立索引器<br>点积 + topk"]
    end

    subgraph IndexShare["IndexShare(每4层共享)"]
        I1["层1: 轻量索引器<br>点积 + topk"]
        I2["层2: 复用层1 topk<br>❌ 省去点积+topk"]
        I3["层3: 复用层1 topk<br>❌ 省去点积+topk"]
        I4["层4: 复用层1 topk<br>❌ 省去点积+topk"]
    end

    传统DSA -->|IndexShare 改进| IndexShare

    style IndexShare fill:#0f3460,stroke:#533483,color:#fff
    style I2 fill:#533483,stroke:#e94560,color:#fff
    style I3 fill:#533483,stroke:#e94560,color:#fff
    style I4 fill:#533483,stroke:#e94560,color:#fff
IndexShare 核心机制:
- 每 4 个稀疏注意力层共享一个轻量索引器
- 索引器放置在第 1 层,计算点积 + topk
- 后续 3 层直接复用 topk 索引,省去 3/4 层的索引器点积和 topk 运算
- 在 1M 上下文下,per-token FLOPs 降低 2.9x
- 从 mid-training 阶段起以 128K 序列长度训练
💡 注意:理论 FLOPs 降低(2.9x)与实际 wall-clock 加速有差距。arxiv 论文 2603.12201 报告 IndexCache 的实际加速为 1.82x prefill / 1.48x decode——这是 wall-clock 指标而非理论 FLOPs,度量口径不同。
编码能力演进
xychart-beta
    title "编码 Benchmark 评分演进"
    x-axis ["NL2Repo", "SWE-Bench Pro", "Terminal-Bench 2.1"]
    y-axis "评分" 0 --> 100
    bar [35.9, 55.1, 0]
    bar [42.7, 58.4, 63.5]
    bar [0, 62.1, 81.0]
| Benchmark | GLM-5 | GLM-5.1 | GLM-5.2 | 差值 (5→5.1) | 差值 (5.1→5.2) |
|---|---|---|---|---|---|
| NL2Repo | 35.9 | 42.7 | — | +6.8 | — |
| SWE-Bench Pro | 55.1 | 58.4 | 62.1 | +3.3 | +3.7 |
| Terminal-Bench 2.1 | — | 63.5 | 81.0 | — | +17.5 |
| FrontierSWE | — | — | 74.4 | — | — |
📊 Terminal-Bench 的 +17.5 分跃升是 GLM-5.2 最显著的编码进步;SWE-Bench 的 +3.7 分为 modest 提升。注意:部分第三方源报告 GLM-5.1 Terminal-Bench 为 62.0(而非 63.5),官方澄清这是 Terminus-2 harness vs Best Reported harness 的配置差异。
前端/设计能力
GLM-5.2 在 Design Arena 的单轮 HTML Web Design 评测中排名 第 1(超越 Claude Fable 5、Opus 4.6/4.7),详见 📝 How GLM-5.2 Beat Fable 5 at Website Design。
关键特征:
- 91% 会话使用 TailwindCSS,51% 使用 font-awesome
- 对 chart.js、three.js 等依赖库调用更自然,6.0 百分点胜率提升
- 生成代码量 25%更多,平均耗时 304.7 秒(2x于 Fable 5)
- 价格优势显著:$1.40/$4.40 per 1M tokens vs Fable 5 的 $10/$50
GLM-5.1:从策略耗尽到长程自主
flowchart LR
    subgraph 问题["GLM-5 的局限"]
        P1["早期耗尽策略<br>性能较早停滞"]
    end

    subgraph 方案["GLM-5.1 的突破"]
        S1["多轮 SFT + RL"]
        S2["过程质量评估框架"]
        S3["600+迭代持续有效"]
    end

    subgraph 验证["验证案例"]
        V1["Linux 桌面构建"]
        V2["向量DB优化<br>21.5k QPS"]
        V3["最长 8h 自主工作"]
    end

    问题 --> 方案 --> 验证

    style 问题 fill:#e94560,stroke:#c0392b,color:#fff
    style 方案 fill:#0f3460,stroke:#533483,color:#fff
    style 验证 fill:#16213e,stroke:#0f3460,color:#fff
GLM-5.1 的核心定位:agentic engineering 旗舰模型,不是通用能力的全面提升,而是针对性解决"Agent 任务中模型早期策略耗尽后性能停滞"的问题。
验证细节:
- SIFT-1M 向量搜索优化中,GLM-5 在较早迭代后停滞,而 GLM-5.1 在 600+ 迭代后仍持续发现有意义改进
- 官方文档声明支持最长 8 小时自主工作(规划→执行→迭代优化)
- 已知局限:Claude Opus 4.6 在 KernelBench Level 3 上仍优于 GLM-5.1(4.2x vs 3.6x)
技术迭代脉络
mindmap
    root((GLM-5 系列演化))
        架构层
            MoE 扩展<br>355B/32B → 744B/40B
            DSA 稀疏注意力<br>GLM-5 引入
            IndexShare<br>GLM-5.2 引入<br>每4层共享索引器
            slime RL 基础设施<br>异步训练 + 开源
        训练层
            预训练数据<br>23T → 28.5T tokens
            多轮 SFT + RL<br>GLM-5.1 核心
            过程质量评估<br>GLM-5.1 新增
            mid-training 128K<br>GLM-5.2 IndexShare 训练
        能力层
            系统工程 + Agent<br>GLM-5 定位
            程自主工作<br>GLM-5.1 8h
            1M 长上下文<br>GLM-5.2 核心
            编码 SOTA<br>GLM-5.2 开源最强
        基础设施
            MIT 开源许可<br>全部三代
            slime 异步 RL<br>THUDM/slime
            多阶段发布<br>API → 开源权重
注意事项与局限
⚠️ 自评估偏差
几乎所有 benchmark 数据均为智谱 AI 自报告。llm-stats 对 NL2Repo 标记 "zero independent verification"。虽然部分数据出现在 BenchLM 等独立追踪器上,但缺乏第三方复现。
⚠️ 营销措辞 vs 技术事实
| 官方表述 | 实际含义 |
|---|---|
| "lossless(无损)长上下文" | 独立源用更审慎的 "solid/stable" |
| "wide margin lead" | 仅指与前代的差距,非全局领先 |
| "开源 SOTA" | 仅限开源模型范畴(闭源 Claude Opus 4.8 仍领先) |
⚠️ 发布日期歧义
GLM-5.2 的"6月16日发布"实际包含多阶段:
- 6月13日:Coding Plan 订阅用户可用
- 6月16日:API / 广泛可用
- 6月17日:开源权重发布
⚠️ 未确认问题
- GLM-5.1/5.2 的具体参数规模是否与 GLM-5 一致(744B/40B)?
- IndexShare 的 wall-clock 加速(1.82x/1.48x)远低于理论 FLOPs 降低(2.9x),瓶颈因素是什么?
- GLM-5.1 的 8h 自主工作能力是否仅限于编码 demo?
- GLM-5.2 的前端/后端提升声明缺乏独立 benchmark 数据
⚠️ 时效性
GLM-5.2 发布仅 4 天(2026-06-16),独立深度评测尚少,benchmark 数据可能随第三方复现而修正。
被否决的 Claim(对抗验证淘汰)
以下 claim 经 3-投票对抗验证后被否决(0-3 或 1-2 vote),不应采信:
| 被否决 Claim | Vote | 原因 |
|---|---|---|
| GLM-5.1 与 Claude Opus 4.6 全面对齐 | 0-3 | 过度夸大,未获任何验证者支持 |
| 三代共享 744B/40B MoE 架构 | 1-2 | 参数规模未获独立确认 |
| GLM-5 早期耗尽策略而停滞 | 0-3 | 说法过于绝对,缺乏独立证据 |
| GLM-5.1 SWE-Bench Pro 超越 GPT-5.4/Opus 4.6 达全局 SOTA | 0-3 | 与已知评测数据矛盾 |
| GLM-5.2 为 753B 参数 | 0-3 | 与官方 744B 声明矛盾 |
| GLM-5.2 "lossless" 1M 上下文 | 1-2 | "lossless" 为营销措辞 |
本文基于深度调研(101 子代理、19 源、94 claim、3-投票对抗验证)生成,置信度分级标注。更新日期:2026-06-20。