AIO Sandbox 技术洞察:一个 AI Agent 沙箱的设计哲学
摘要:AIO Sandbox 是火山引擎开源的 All-in-One Agent 沙箱,将 Browser、Shell、Jupyter、VSCode、MCP 等能力打包进单个 Docker 容器。本文从源码角度分析其六大设计亮点:① 单容器多进程——用资源换掉分布式协调复杂度;② Fern 代码生成——API 定义作为唯一真相,多语言 SDK 自动生成;③ Shell/Bash 双轨——区分有状态交互与无状态异步执行;④ Discriminated Union 浏览器操作——对齐 CUA 标准,降低 AI 调用成本;⑤ MCP Hub 代理层——统一调用容器内所有 MCP 工具;⑥ Skills 持久化记忆——让 Agent 能将有效解法固化为可审计、可修正的外部存储。核心启示:把 AI Agent 当作一等公民来设计接口。
AIO Sandbox 技术洞察:一个 AI Agent 沙箱的设计哲学
基于源码阅读,记录几个值得深思的设计决策。💡 阅读提示:文中标注 ⚡ 架构师容易忽略 的段落,是最值得停下来思考的地方。
———
背景
AIO Sandbox 是火山引擎 Agent Infra 团队开源的 All-in-One Agent 沙箱环境,把 Browser、Shell、File、Jupyter、VSCode、MCP 等能力打包进单个 Docker 容器,对外暴露统一 HTTP API。
这篇文章不是功能介绍,而是从源码角度聊几个有意思的设计选择。
———
一、单容器多进程:用最朴素的方式解决最棘手的问题
传统 Agent 沙箱的痛点是工具孤岛——浏览器下载的文件,代码执行环境看不到;Shell 生成的数据,Jupyter 无法直接读取。解决方案通常是搞一套复杂的跨容器文件同步机制。
AIO Sandbox 的答案是:根本不需要同步,因为它们本来就在同一个进程空间里。
容器内部(/home/gem 共享文件系统) ├── Browser 进程 :9222 ├── Shell/Bash 服务 :8091 ├── Jupyter Lab :8888 ├── VSCode Server :8200 ├── MCP Hub :8079 └── 统一网关 :8080 ← 对外唯一入口
⚡ 架构师容易忽略大多数人看到"多工具协作"问题,第一反应是设计消息队列、共享存储、事件总线。这里的反直觉之处在于:解决方案不是加新东西,而是不拆开。架构师的本能是"关注点分离 → 拆成微服务",但这个场景下拆分本身就是问题的来源。单容器不是妥协,是刻意的选择——用资源换掉了一整层分布式协调的复杂度。下次遇到"多工具数据共享"问题时,先问自己:它们真的需要分开吗?
代价是容器比较重(推荐 8GB 内存、4 核 CPU),但换来的是零配置的工具协作体验。
———
二、Fern 代码生成:API 定义是唯一真相
SDK 不是手写的。整个多语言 SDK 体系的源头只有一个文件:
website/docs/public/v1/openapi.json ↓ fern generate sdk/python/agent_sandbox/ (Python) sdk/js/src/ (TypeScript) sandbox-sdk-go/ (Go)
sdk/fern/generators.yml 定义了生成规则,三个语言的 SDK 从同一份 OpenAPI spec 生成,接口永远保持一致。
这个选择的深层含义是:服务端 API 的变更会自动传播到所有客户端,不存在"Python SDK 更新了但 Go SDK 还是旧版"的问题。 对于一个需要维护多语言 SDK 的基础设施项目,这几乎是唯一正确的做法。
生成的每个资源模块都有两层:
- client.py — 高层封装,直接返回 .data,日常使用
- raw_client.py — 返回完整 HTTP 响应,需要状态码或 header 时使用
⚡ 架构师容易忽略这个两层结构暗藏一个重要的 API 设计原则:为 80% 的场景提供简洁接口,同时为 20% 的场景保留逃生通道,而不是用一个"万能但复杂"的接口覆盖所有情况。很多团队设计 SDK 时会陷入"要不要暴露底层细节"的两难。这里的答案是:两个都暴露,但分层。client 是默认路径,raw_client 是显式选择。用户永远知道自己在用哪一层。
———
三、Shell vs Bash 双轨:执行模型的精细化
表面上看 shell 和 bash 是重复的,实际上它们解决的是两个不同的执行场景:
Shell — 有状态交互式会话
session = client.shell.create_session() client.shell.exec_command(command="python3", id=session.id) client.shell.write(input="print('hello')\n", id=session.id) output = client.shell.view(id=session.id)
适合需要交互的场景:REPL、需要输入密码的命令、长期保持环境变量的会话。
Bash — 无状态异步执行
# 立即返回,后台跑 result = client.bash.exec(command="npm run build", async_mode=True) # 轮询结果 output = client.bash.output(session_id=result.data.session_id)
bash.exec 的超时设计尤其值得注意:
- timeout:HTTP 层超时,超时后命令继续在后台跑,返回 RUNNING 状态
- hard_timeout:进程级超时,超时直接 kill
- max_output_length:超长输出做中间截断(保头保尾,截中间)
⚡ 架构师容易忽略 — 中间截断输出截断通常有三种策略:截头、截尾、截中间。大多数系统默认截尾(head -n 100)或截头(tail -n 100)。这里选择截中间,是专门为 AI 调用场景优化的:命令开头往往有关键的环境信息、错误前缀 命令结尾往往有最终结果、退出状态 中间的冗长日志才是真正的噪音 这个细节说明设计者在认真思考"AI 作为调用方"和"人作为调用方"的需求差异。为 AI 设计接口,和为人设计接口,有时候需要不同的默认值。
———
四、Browser Action 的 Discriminated Union:对齐 CUA 标准
浏览器操作没有设计成一堆独立 API(click(x,y)、type(text)、scroll()...),而是统一的 execute_action 接口,靠 action_type 字段区分:
Action_MoveTo (action_type="MOVE_TO", x, y) Action_Click (action_type="CLICK", x, y, button, num_clicks) Action_Typing (action_type="TYPING", text) Action_Hotkey (action_type="HOTKEY", key) Action_Scroll (action_type="SCROLL", ...) Action_DragTo (action_type="DRAG_TO", ...) Action_DragRel (action_type="DRAG_REL", ...)
这是 CUA(Computer Use Agent)的标准动作空间设计,跟 Anthropic Computer Use、OpenAI CUA 的接口思路一致。
⚡ 架构师容易忽略 — 接口形状决定集成成本如果浏览器操作是一堆独立 API,AI 模型输出一个动作后,调用方需要写 if action == "click": client.click(...) 这样的分发逻辑。用 Discriminated Union 之后,模型输出的 JSON 可以直接反序列化成 Action 对象传入,零适配。这是一个"接口形状与调用方数据结构对齐"的典型案例。接口不只是功能的暴露,也是调用方工作量的转移。设计接口时值得问:调用方拿到响应后还需要做多少转换工作?
———
五、MCP Hub:从工具调用到协议代理
MCP 模块不是直接暴露工具,而是一个代理层:
AI Agent → client.mcp.execute_mcp_tool(server_name="browser", tool_name="navigate", args) → 容器内 MCP Hub (:8079) → browser-mcp (:8100) → file-mcp → shell-mcp → markitdown-mcp (:8101)
Agent 只需要一个 HTTP 连接,就能调用容器内所有 MCP server 的工具,不需要管理多个 MCP 连接的生命周期。
⚡ 架构师容易忽略 — 自举式评测更隐蔽的巧妙在评测框架里。evaluation/main.py 直接用 streamablehttp_client 连接沙箱的 MCP 端点来跑评测:MCP_SERVER_URL = "http://localhost:8080/mcp" _mcp_streams = streamablehttp_client(server_url) 产品即测试环境——评测框架本身就是 MCP 客户端,用沙箱自己的接口来测沙箱。这意味着:评测用例覆盖的,正好是真实用户会走的路径;评测发现的问题,正好是真实用户会遇到的问题。不需要维护一套独立的 mock 环境,也不存在"测试环境和生产环境行为不一致"的问题。当你的产品本身就是最好的测试工具时,不用它来测自己是一种浪费。
———
六、Skills:给 Agent 的持久化过程记忆
Skills 的完整生命周期:
register(file) → list_metadata() → get_content(name) → execute(name, args) → delete(name)
表面上是"上传脚本、按名调用",但背后的设计意图更深:让 Agent 能把有效的解法固化下来。
Agent 在完成一个复杂任务后,可以把解法打包成 Skill 存进沙箱。下次遇到类似任务,直接调用已验证的 Skill,而不是让 LLM 重新推理生成代码。
⚡ 架构师容易忽略 — 记忆的存储位置决定其性质AI 系统的"记忆"通常有三个位置:模型权重(训练时固化,不可动态修改) Context Window(当次会话有效,会话结束即消失) 外部存储(持久化,可检索,可审计) Skills 把解法存在第三层——沙箱文件系统。这带来了几个权重和 context 都做不到的特性:可审计:人类可以直接读取、检查 Skill 的内容 可修正:发现 Skill 有 bug,可以直接修改文件 跨会话复用:不依赖 context 长度,不受模型遗忘影响 这是一个把"AI 能力"和"软件工程实践"结合的设计——用文件系统的可靠性,弥补 LLM 的不稳定性。
———
总结
回顾这几个设计,有一条隐含的主线:把 AI Agent 当作真正的一等公民来设计接口。
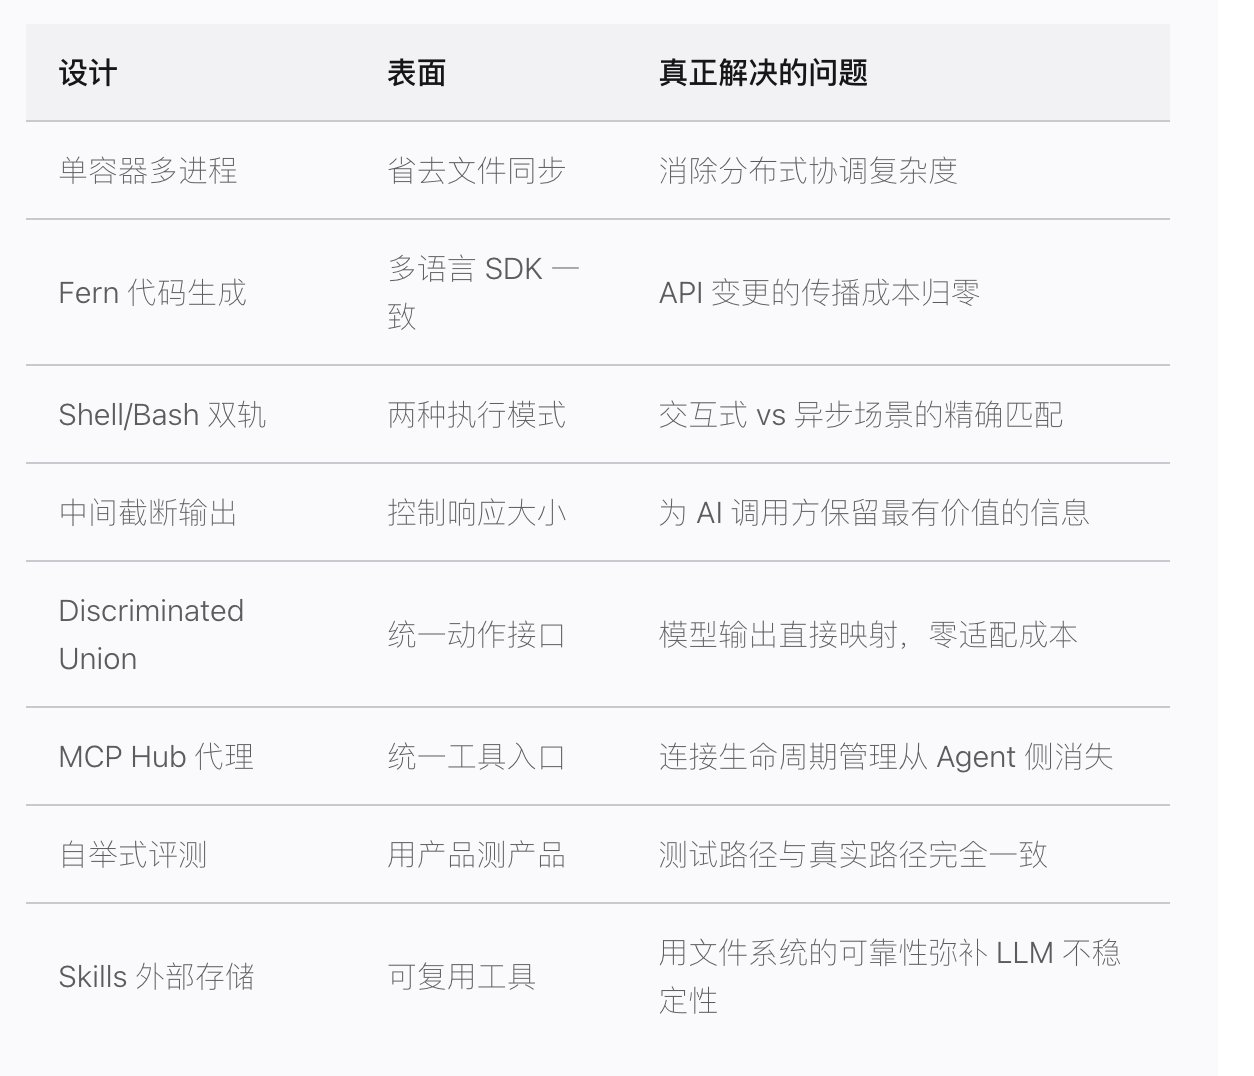
这不是一个"给人用的开发环境加了个 API",而是从 Agent 的视角重新设计了执行环境应该长什么样。